
深度解析医学证据,DeepEvidence为你支撑决策
药物-靶点相互作用(DTI)是指药物与体内蛋白酶、受体等生物大分子之间发生的直接结合过程,是阐明药物作用机制、发现候选靶点和推进新药研发的重要基础。当前,仍有相当数量药物的作用靶点尚未被充分解析,这不仅限制了对药物机制与安全性的深入认识,也在一定程度上影响了研发效率[1]。我国药物靶点研究数据显示,截至2024年1月,国内在研药物靶点总数约为670个,较2021年增加295个,表明靶点资源积累正在加快[2]。但与此同时,靶点布局仍存在聚焦度过高、原创靶点相对不足等问题,这说明仅靠传统试错式筛选已难以满足高效率、高精度的研发需求[3]。
随着人工智能(AI)技术的发展,基于AI的DTI预测已成为加速药物研发的重要工具,可用于候选筛选、药物重定位和先导优化[4-5]。本文围绕常用数据类型、基准数据集和核心建模方法展开综述,并讨论主要挑战与未来方向。除方法学比较外,DTI研究的临床价值还体现在靶点生物学功能与疾病相关性的识别,以及预测结果与药理实验、机制验证和后续开发流程的衔接能力。
因此,DTI预测的评价不应仅停留于曲线下面积(AUC)、一致性指数(CI)或均方误差(MSE)等算法指标,还应重视其能否帮助研究者缩小候选范围、提出可检验的作用机制假设,并为体外活性测定、细胞功能实验和动物药效研究提供更高优先级的验证线索。本文旨在为AI驱动的DTI预测领域相关研究与产业落地提供参考。
1DTI技术常用数据类型和基准数据集
DTI预测的准确性与可靠性核心依赖于高质量的数据表征与标准化的基准评估体系。数据作为AI模型训练的“原料”,其完整性、代表性直接决定模型的泛化能力,而基准数据集则为不同预测方法提供了统一的对比平台,是衡量技术进展的核心依据。
1.1数据类型
DTI预测的数据类型围绕“药物-靶点-关联”三元结构展开,分别从分子层面、生物大分子层面及二者相互作用层面提供特征支撑,具体包括药物表征数据、靶点表征数据和药物-靶点关联数据三类。数据类型的丰富并不等同于数据质量可靠。不同类型数据在采集方式、表征粒度、实验条件和预处理流程上存在差异,易在训练阶段转化为噪声累积、标签不一致和分布偏差。
1.1.1 药物表征数据
药物表征数据是描述小分子化合物化学本质与结构特征的核心数据,其核心作用是将药物的物理化学属性转化为AI模型可识别的数值或结构形式。目前主流的表征形式主要有以下3种:
1简化分子线性输入规范(SMILES)通过字符串编码药物的原子组成、化学键连接方式及官能团信息,是较常用的药物文本表征形式,可直接输入序列模型或通过预训练模型转化为向量特征;
2分子指纹(molecular finger-prints)通过哈希函数将药物结构转化为固定长度的二进制向量,如ECFP4指纹可有效捕捉分子亚结构特征,广泛应用于传统机器学习模型的特征输入;
3分子图结构(molecular graph)以图数据格式将药物分子建模为“原子-化学键”的拓扑结构,能够保留分子的空间连接关系,是图神经网络(GNN)类模型的核心输入形式。
以上3类数据从不同维度刻画药物特征,共同支撑模型对药物化学性质的理解。现有DTI研究框架、公开基准及多数代表性模型主要围绕小分子化学药建立,因此,药物表征的相关讨论通常默认以小分子为中心。而生物药同样构成当前药物研发的重要部分,此类药物在分子大小、构象稳定性、修饰方式、作用界面和成药评价上均不同于小分子,其表征更依赖一级序列、三维结构、翻译后修饰位点以及药物-靶点复合体界面等信息。面向生物药的相互作用预测、亲和力评估与作用界面建模,因此成为后续数据集建设和模型扩展的重要方向。但此类表征可带来噪声与偏差,例如SMILES标准化差异会影响序列表征一致性、分子指纹会损失部分结构细节、静态分子图难以完整反映真实构象、立体化学和溶剂效应。
1.1.2 靶点表征数据
靶点表征数据聚焦于蛋白质、核酸等生物大分子的序列与结构特征,为模型提供药物作用对象的生物学信息。蛋白质序列数据以FASTA格式存储氨基酸残基序列,包含蛋白质的一级结构信息,通过序列比对、特征提取(如PSSM谱、氨基酸组成向量)可转化为模型输入。蛋白质结构数据以PDB格式记录三维空间结构,涵盖二级结构(α-螺旋、β-折叠)、三级结构(活性位点、结构域)及四级结构(多亚基组装)信息,能够反映药物结合的空间适配性。
此外还包括结构域与功能注释数据,可间接补充靶点的生物学功能信息,辅助模型挖掘“结构-功能-结合”的关联规律。此类数据的核心价值在于揭示靶点的生物特性,为预测药物与靶点的相互作用机制提供生物学依据。靶点表征不仅涉及结构可计算性,也关系到其在疾病发生发展中的致病通路位置、组织表达谱、遗传学证据和潜在安全性窗口。
将“能否结合”与“为何值得干预”结合起来,DTI预测结果才更有可能转化为具有药理意义和临床开发价值的候选线索。临床上真正有价值的候选靶点通常还需同时满足疾病相关性明确、干预后具备可观药效空间、组织分布和安全性风险可评估等条件。因此,若模型仅在统计意义上预测出“可能结合”,却无法与靶点所处通路、疾病表型、耐药机制或患者分层信息建立联系,则其医学解释力和转化价值仍有限。
然而,靶点侧数据同样存在不确定性。蛋白质序列难以直接体现动态构象和口袋柔性,实验结构覆盖也高度不均衡,使G蛋白偶联受体(GPCR)、离子通道等家族在部分场景下仍面临结构信息不足,跨库功能注释整合也可能引入标签不一致与冗余噪声。
1.1.3 药物-靶点关联数据
药物-靶点关联数据是DTI预测的监督信号,即模型训练所需的真实标签,直接定义药物与靶点是否相互作用及相互作用的强度。根据标注形式的不同,此类数据可分为二分类标签与量化标签两类。其中,二分类标签以“1”(存在相互作用)和“0”(不存在相互作用)标注药物-靶点对的结合状态,数据主要来源于实验验证的阳性交互对(如DrugBank中的已验证关联)与随机生成的阴性对照对,适用于分类任务的模型训练。而量化标签以结合亲和力数值(如Kd、Ki、IC50、EC50)表示药物与靶点的结合强度,数值越小表示结合能力越强,数据多来源于BindingDB、PDBbind等实验数据库,适用于回归任务的亲和力预测。此类数据是构建监督学习模型的核心,其标注准确性直接影响模型的预测性能。
在上述3类数据中,关联标签数据往往是偏差较直接的来源,具体表现为以下3个方面。
其一,阳性样本远多于高质量阴性样本,随机构造负样本易引入伪阴性;
其二,不同数据库的活性阈值和实验体系不有效缓解一致;
其三,热门靶点与热门药物的富集使监督信号呈显著的长尾分布。针对上述问题,研究者已提出多种改进策略。
1阴性样本构造方面,主要策略包括:基于化学空间距离的负采样通过计算候选分子与已知活性分子的结构相似性,选择处于化学空间特定阈值范围内的分子作为阴性对照,以避免引入与活性分子过于相似的潜在假阴性;困难负样本挖掘则通过预训练模型或集成学习方法,识别出模型易误判的边界样本,将其纳入训练可显著提升模型的判别能力[6];基于网络拓扑约束的负样本筛选则利用药物-靶点异质网络的拓扑特性,排除在网络层面与已知阳性关联存在强连接隐含关系的药物-靶点对,以降低假阴性比例并提升监督信号的可靠性。
2活性阈值标准化方面,通过统一量化标准、跨数据库活性值校正及实验条件归一化等手段,可缓解不同来源数据的标注不一致性,使模型在多源数据融合时保持稳定的判别边界[7]。
3分布偏差校正方面,平衡采样通过对热门靶点和热门药物进行下采样、对稀有靶点和新颖药物进行上采样,构建更均衡的训练分布;逆频率加权则在损失函数中根据样本出现频率赋予不同权重,使模型更加关注稀有样本;靶点家族分层采样则确保不同靶点家族在训练集中保持均衡比例,以减轻热门靶点与热门药物的富集效应,使模型在长尾分布下仍能保持对稀有靶点和新颖药物组合的预测能力。
1.2基准数据集
基准数据集是DTI预测领域开展模型性能评估、实现不同方法公平对比的核心标准化平台,直接决定模型验证结果的可信度,是推动领域规范化发展的核心基础。目前,DTI领域已形成覆盖不同任务、模态与应用场景的基准数据集体系,为AI方法的研发与验证提供了核心数据支持。
Davis与KIBA是DTI分类、药物-靶点亲和力(DTA)回归任务中应用较广泛的通用基准,二者均聚焦激酶蛋白家族与对应抑制剂的相互作用,收录经实验验证的互作对与定量活性数据,可同时适配二分类互作预测与结合亲和力回归两类核心任务。其中Davis数据集规模适中、标注精度高,以解离常数Kd作为亲和力量化指标;KIBA数据集覆盖范围更广、数据多样性更强,整合了IC50、Kd、Ki三类活性值,是多靶点预测模型的核心评估基准。二者也可作为观察模型跨任务与跨标注体系稳定性的基础参照。
针对DTI二分类预测任务,领域内已形成多款经典的基准数据集。为缓解天然互作数据中正负样本分布失衡的问题,部分研究在既有数据库基础上进一步构建了相对均衡的评测版本。Gold-standard数据集作为领域较早的标准化基准之一,覆盖酶、GPCR、离子通道及核受体4类靶点,是单靶点家族模型验证的重要依托。DrugBank与BioSNAP相关数据集则广泛用于大规模DTI模型的训练及泛化性能验证,但其样本均衡方式、负样本构造策略及预处理流程在不同研究中尚未统一。此外,Human与C.elegans数据集则为跨物种DTI研究提供了常用的标准化数据支撑。
在基于三维结构的DTI预测研究中,PDBbind与DUD-E是两类常用专用基准。PDBbind同时提供蛋白质-配体复合物三维结构和实验亲和力标签,更适合结构驱动的亲和力预测;DUD-E主要用于虚拟筛选评测,常考察模型区分活性分子与诱饵分子的能力,但其诱饵构造机制可能使结果偏乐观。
针对多模态融合与网络药理学相关的DTI研究,领域内已形成专用的异质网络基准数据集,其中以DTINet较具代表性。该数据集整合了药物、蛋白、疾病、副作用4类生物实体及多类生物互作关系,可为融合多源生物信息的DTI模型研发提供系统化的数据支撑。
除标准化基准数据集外,BindingDB、ChEMBL、PubChem、UniProt、PDB等权威生物数据库是DTI基准构建与模型特征提取的核心底层支撑。常用来源包括DrugBank[8]、BindingDB[9]、ChEMBL[10]、PubChem[11]、UniProt[12]和RCSB PDB[13]。然而,这些数据库普遍存在负样本不足、热门靶点富集和跨库标注不一致等偏差。因此,方法比较应尽量采用统一划分、统一指标和明确冷启动设定。
上述数据库覆盖小分子化合物结构、蛋白序列与三维结构、结合亲和力等全维度信息,与标准化基准共同构成了DTI预测领域完整的数据支撑体系,为AI方法的创新与落地提供了稳定的数据保障。除底层数据库外,DTI领域已涌现出若干网页服务器和开源工具,可用于候选筛选、靶点排序与初步预评估。
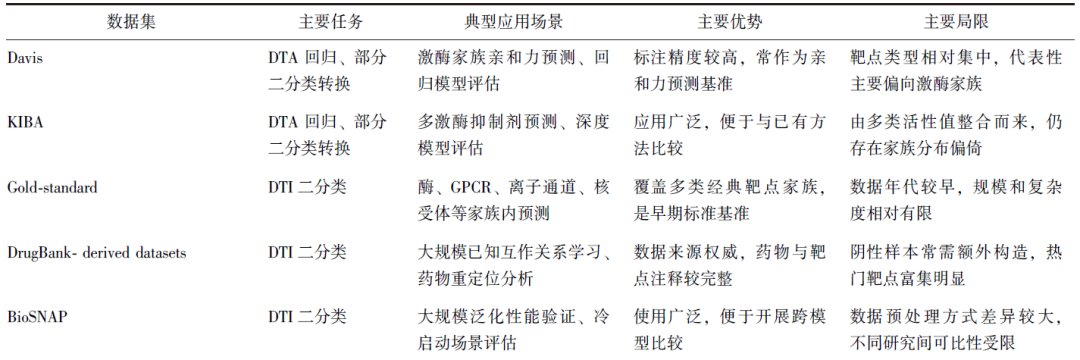
然而,现有工具多为单点预测或局部流程模块,更适合作为实验前的辅助手段,而非替代药理实验或机制验证。这表明DTI研究正由算法比较走向工具化探索,并为后续智能体化系统的构建奠定基础。常用经典数据集的任务定位与适用边界详见表1。不同数据集的构建目标各异,因此不能脱离具体任务设置进行简单横向比较。
表1DTI领域经典数据集的任务定位与适用边界比较
2DTI预测常用AI方法
当前常用的AI方法主要包括传统机器学习、深度学习和多模态等,在DTI预测中各有优势。DTI方法在技术演进过程中经历了人工特征驱动、表示学习驱动和多源融合驱动三个阶段,因此,以下根据技术瓶颈与升级路径进行论述。同时,不同研究在数据划分、冷启动设定和评价指标上并不一致,故本文强调应在同一数据集、同一协议和同一指标下进行方法比较。其中,二分类任务常用AUC和精确度-召回率曲线下面积(AUPR),亲和力预测任务常用CI、MSE、均方根误差(RMSE)及Pearson相关系数。以下从单模态和多模态两个方面对现有方法进行介绍。
2.1单模态方法
单模态方法围绕单一主导表征空间建模,如分子序列、分子图、蛋白质序列或蛋白质结构,其优势在于路径清晰、训练代价较低,同时便于分析单类表征的贡献;但性能高度依赖输入信息的完备性,难以同时利用结构、功能与网络背景。因此,评价单模态方法时不能只关注单次结果,还应关注其在不同数据集、靶点家族和冷启动场景中的稳定性。
2.1.1 基于传统机器学习的DTI预测
机器学习方法长期以来在药物发现中发挥着重要作用[5,14]。基于支持向量机[15-16]、随机森林[17]、朴素贝叶斯及人工神经网络[18]等传统机器学习方法,相关研究主要围绕三大核心维度展开:预测药物在靶分子上的结合位点、评估药物与靶标间的结合亲和力,以及确定药物在靶分子内的结合构象或构型[19]。根据建模策略[20],DTI预测方法可分为矩阵分解[21]、基于相似性[22]、基于网络[23]及基于特征[24-25]的方法(图1),也包含融合多种策略的混合模型。
图1基于传统机器学习的DTI预测方法
图1概括了传统机器学习阶段的主要建模思路,亦阐释了该阶段为何以相似性利用、特征工程和监督信号重组为核心。因其依赖预定义表示与规则,后文将进一步阐述其在复杂非线性交互及跨分布泛化方面的局限性。矩阵分解类方法通过降维提取关键特征,可对高维药物-靶点关联数据实现降噪与冗余剔除,并可结合正则化或多源相似性以缓解数据稀疏问题,代表性改进包括自步学习双相似性矩阵分解[26]和双指标优化矩阵分解[27]。
基于相似性的方法主要分为两类范式:
1双实体特征匹配范式,分别对药物与靶点进行建模,构建属性表征空间并融合多源相似性推断交互关系;
2跨模态整体匹配范式,将药物-靶点对作为联合单元,探索生物医学数据的全局相似性分布。
随着多维度生物数据的积累,该类方法逐渐突破二元关联局限,通过整合药物、靶点、疾病等异构信息构建多维度相似性网络,从而提升相似性度量的稳健性与泛化能力。例如,Song等[28]提出一种多视图相似性网络融合策略,能够在无监督条件下有效整合药物和靶点的多维属性信息,并利用交互注意力机制提取深层鉴别特征,其性能显著优于传统的单一相似性度量方法。
相似性方法的核心是通过距离度量或关联规则捕捉对象内在相似性,而基于网络的建模方法与之存在显著技术差异:后者将药物、靶点等生物实体抽象为网络节点,以节点间连接表征实体交互,通过路径传播、社区发现、网络嵌入等算法挖掘拓扑结构中的间接关联。两类方法技术路径不同,可通过协同融合实现优势互补。例如,Su等[29]提出一种基于自适应元图学习的异构网络预测方法,将多模态生物数据构建为类似知识图谱的复杂关联网络,通过训练自适应元图自动聚合拓扑结构中的细粒度语义信息。该框架有效突破了传统网络对特定领域规则的依赖,在充分覆盖海量节点关联的同时,显著增强了底层网络图谱特征捕获的鲁棒性,从而大幅提升了DTI预测的可靠性。
特征导向的DTI预测方法以特征工程为核心,包含特征筛选、多源特征整合及特征导向建模三大技术分支,其方法学构建与性能优化高度依赖生物医学领域先验知识。特征筛选通过相关性分析、正则化约束等策略,从高维异构数据中筛选核心特征、实现降维优化,为建模提供高质量输入;多源特征整合技术通过融合药物分子结构、靶点蛋白功能等异构数据源,构建综合特征表征体系,突破单一数据的表征局限;特征导向建模则基于筛选后的核心特征开展预测建模,依托先验知识提升预测准确性。
例如,Lu等[30]提出一种基于专家混合机制的特征导向预测框架,该方法通过构建多个专家模块分别处理靶点与配体的多源异构数据,进而自适应地筛选与提取较具判别力的核心特征集。该框架创新性地将多专家特征选择与置信度评估逻辑有机融合,通过动态路由机制实现高维复杂分子特征的降维与提纯,又可强化特征分布与生物学结合作用的关联性,较终在模型预测结果的可解释性层面展现出显著优势,为结合机制的解析提供了更清晰的特征支撑。
随着机器学习方法的持续演进,现有研究通过整合多条技术路径,实现对DTI预测问题的有效求解。例如,Zhang等[31]提出一种融合多视图图结构与邻域正则化逻辑矩阵分解的联合建模方法,通过构建多源相似性空间并生成对应的拉普拉斯矩阵进行深度图谱融合,有效克服了传统单矩阵分解在极端稀疏数据下表征能力不足及易引发过拟合的问题,同时弥补了常规逻辑矩阵分解难以深度刻画高维多源复杂网络拓扑信息的缺陷。
总体而言,机器学习方法具有训练成本较低、对中小规模数据较友好、部分模型可解释性较强等优势,但其性能较大程度依赖人工特征设计与相似性假设。当任务涉及跨家族泛化、未知药物或未知靶点预测以及复杂空间构象信息建模时,此类方法通常难以充分刻画深层的非线性交互关系。这一瓶颈直接推动了深度学习方法从“特征输入驱动”向“表示学习驱动”的转变。从适用边界来看,传统方法在激酶等已有较丰富活性数据与相似性先验的场景中,仍可构成有竞争力的基线—此时相似性传播、矩阵补全和特征筛选更易发挥作用。
然而,对于GPCR、离子通道及核受体等结构多样性较高、标注更稀疏的靶点家族,单纯依赖浅层特征与相似性归纳通常难以稳定捕获复杂的结合规律。也正因如此,后续方法的发展重点不再仅是“如何在既有特征上提高分类器性能”,而是逐步转向“如何让模型从原始序列、图结构和上下文信息中自动学习更具泛化性的表示”,这也构成了单模态深度学习方法兴起的直接动因。
2.1.2 基于深度学习的DTI预测
深度学习DTI预测方法围绕药物与蛋白质表征学习及其相互作用建模展开,形成了多种具有代表性的技术路径。考虑到“图结构”属于数据表示层面的划分,而“长程依赖建模”更接近模型机制层面的划分,二者在诸多实际模型中并非彼此独立,因此本文不再将其简单并列为互斥类别,而是按照“核心表征偏置与主要建模重心”进行归纳。
具体而言,现有方法可概括为以下五类:以卷积或自编码器为核心的局部模式建模、以GNN为核心的拓扑结构建模、以注意力机制或Transformer为核心的全局依赖建模、以大规模预训练为核心的语义表示学习,以及融合外部知识或高阶结构先验的增强建模。需要说明的是,后一阶段方法往往是对前一阶段方法的扩展而非替代,例如GNN模型也常与注意力机制、预训练表示或知识图谱共同使用。图2进一步展示了深度学习阶段的重心已从手工特征设计转向自动表示学习与交互函数建模。与图1相比,其差异不仅在于模型结构更复杂,更在于输入表征粒度、特征抽取层次和长程依赖建模方式发生了系统变化,这也是后文将卷积、图模型、Transformer与预训练方法放在统一框架下比较的依据。
图2基于深度学习的DTI预测方法
基于卷积与自编码器的局部特征表征,将药物和蛋白质序列视为一维离散符号序列,通过卷积核在局部滑动以捕获氨基酸片段或分子-子结构的局部相关模式,同时利用表示学习方法对高维输入进行压缩与映射,从而获得具有判别能力的低维特征表示。Monteiro等[32]以蛋白质序列和化合物SMILES字符串为输入,结合网络嵌入表示与卷积特征提取,实现DTI预测。Zhao等[33]提出DLDTI框架,将网络表示学习与CNN相结合,从药物、靶点及其相互作用网络中学习低维嵌入表示,用于后续预测。
在局部序列模式建模基础上,研究者发现一维序列难以充分刻画分子与蛋白质的结构关系,进而将分子或生物实体抽象为图结构建模。基于GNN的拓扑结构建模方法因此受到广泛关注,该方法将分子或生物实体转化为图结构,通过节点与邻居间的消息传递机制迭代更新节点表示,能够在编码原子或氨基酸属性的同时融合分子整体拓扑结构,并在多层传播中融合高阶邻域信息。
Peng等[34]构建了异质图卷积模型,将药物、蛋白质及相关生物实体整合至统一图结构中,实现多模态信息的联合表示学习。Li等[35]提出基于异质图注意力网络的DTI预测方法,通过注意力机制自适应分配不同类型节点的重要性,并结合扩散机制增强远距离节点的信息传播能力。Yin等[36]提出DeepDrug框架,利用残差图卷积网络和CNN分别对分子结构和序列信息进行建模,在药物-药物相互作用(DDI)与DTI任务中取得较好效果。Sun等[6]提出iNGNN-DTI,通过嵌套GNN结合预训练分子与蛋白表示,提高对复杂交互关系的建模能力。Yu等[37]提出GS-DTI框架,通过图结构感知模块融合蛋白质结构信息与分子图表示,在跨数据集场景下表现出较好的泛化能力。
随着图结构建模能力的提升,捕获长距离依赖关系成为关键问题。研究者引入注意力机制与Transformer结构,构建基于注意力机制与Transformer的长程依赖建模方法,该方法可显式建模序列或图中的全局关联,捕获三维空间中序列遥远但空间邻近的非局部残基接触,通过自注意力机制对序列或图中任意位置关系进行全局建模,动态加权不同位置特征贡献,有效捕获蛋白质长序列远距离依赖及分子间复杂交互。
Cheng等[38]通过图注意力网络结合多头自注意力机制,对蛋白质序列中的关键区域进行加权建模,从而提升DTI预测性能。Wang等[39]基于line graph与GraphTransformer的DTI预测方法,通过将交互关系转换为节点表示并用图Transformer建模,通过多头注意力机制实现药物图结构与靶点序列之间的特征交互。Wen等[40]提出基于多注意力机制的模型,用于刻画原子与氨基酸之间的交互关系,从而提升预测精度。Huang等[41]提出MolTrans,通过子结构模式挖掘与增强型Transformer编码器,提升模型对分子与蛋白质特征的表达能力。Liu等[42]提出基于分子间图Transformer的方法(Intermolecular GraphTransformer),通过专门设计的注意力机制建模分子间的拓扑与空间关系。
除模型结构优化外,另一类方法从数据驱动角度出发,利用大规模无标注数据学习通用表示,基于预训练模型与语言模型的语义表示学习方法应运而生。该方法通过自监督任务学习通用表示,可将离散的SMILES序列或氨基酸序列映射至连续的语义空间,显著提升模型在小样本及新靶点场景下的泛化能力。Jin等[43]通过语言建模方法预训练蛋白质序列表示,并结合深度模型进行DTI预测。Zheng等[44]将Mol2Vec嵌入与注意力机制相结合,在多任务学习框架下进行DTI建模,以提升特征表达能力。Ahmed等[45]提出DTI-LM,利用蛋白质与药物序列的预训练表示,并结合图注意力机制,提高模型在小样本场景下的泛化能力。
为弥补预训练模型难以显式引入领域先验知识的不足,研究者进一步结合知识图谱和拓扑特征开展增强建模。例如,Wu等[46]基于知识图谱注意力网络进行链接预测,Talo等[47]则融合持续同调拓扑特征与预训练语义表示。
从性能提升的来源来看,单模态深度学习方法大致有三条主线:卷积模型强调局部模式提取,效率较高但对长程依赖的建模能力有限;GNN强调拓扑结构与高阶邻域信息,但对图构建质量和计算资源更敏感;Transformer与预训练模型强调全局依赖和表示迁移,在冷启动与跨分布泛化方面更具潜力,但训练成本和解释压力也更高。换言之,经典基准上的性能差异,往往源于表征、任务设定与计算预算的综合权衡。
现有深度学习模型的主要不足还体现在:冷启动泛化仍不稳定,可解释性多停留在间接证据层面,且难以区分真实生物学线索与数据库偏差带来的伪模式。因此,性能提升不能简单等同于生物学可信度提升。不同策略在靶点家族上的适用边界也并不一致。
以Davis和KIBA为代表的激酶数据集为例,模型较易从相对一致的结构模式和较密集的活性标注中获益;而在GPCR、离子通道和核受体等靶点家族中,结构先验和跨分布迁移能力往往比单一基准上的小幅指标提升更重要。因此,判断模型优劣应着眼于“在哪些条件下更有效”,而非单一数据集上的出色结果。单模态与多模态方法详见表2,该表强调相对比较关系与方法学特征,而非脱离实验协议进行机械排名。
表2DTI预测的主要方法比较
为避免停留于定性比较,笔者补充了同一随机划分协议下的代表性量化结果(表3),选择WPGraphDTA在Davis数据集上报告的统一对照结果,并保留KronRLS与SimBoost作为传统基线,以减少跨论文、跨协议横向拼接带来的偏差[48-50]。
表3同一随机划分协议下 Davis 数据集上的代表性量化比较
在同一随机划分协议下,传统方法与新近深度模型之间并非有效代际替代。相较于KronRLS和SimBoost,WPGraphDTA在Davis数据集上取得更高CI(0.895)和更低MSE(0.226),说明显式分子图拓扑与更细粒度蛋白表示的结合能够带来稳定收益。但这种“当先”本质上仍是表示质量与任务设定匹配度的改进,并不意味着同一模型可在所有靶点家族和评测场景中普遍占优,因此,对方法优劣的判断仍需回归统一协议、适用边界与计算代价的综合比较。
总体而言,不同类别方法在建模能力上各有侧重:基于卷积的方法擅长捕获局部模式,GNN可有效刻画分子与生物网络的拓扑结构,注意力机制与Transformer增强了长程依赖建模能力,预训练模型借助大规模数据提升表示泛化性,基于外部知识与高阶结构先验的方法则弥补了纯数据驱动模型的不足。DTI预测方法的演进并非简单叠加模型模块,而是伴随输入组织方式、特征学习层次和交互建模重点的持续变化。
上述方法并不存在单一意义上的“出色模型”:卷积类模型计算开销较可控,更适合快速基线构建,但对远距离依赖和复杂空间关系刻画有限;GNN在结构建模上更具优势,却更依赖图构建质量和计算资源;Transformer及预训练模型在跨数据集泛化上潜力较大,但训练部署成本较高,可解释性也仍不足。
此外,Davis与KIBA等以激酶为主的基准并不能充分代表GPCR、离子通道或核受体等家族,因此,经典基准上的优势未必能直接迁移至不同靶点家族或真实冷启动场景。后续研究不宜仅报告平均性能,还应关注跨家族、跨分布和冷启动场景下的稳定性。基于此,本文更强调“适用条件”而非单纯的“性能排名”:快速筛选或中小样本任务可优先考虑轻量级传统模型或卷积模型;结构拓扑与空间邻域刻画更适合图模型;跨数据集泛化或未知靶点迁移则更需要结合预训练表示、结构先验和多模态融合策略。
然而,单模态深度学习仍受限于单一信息通道,难以同时整合药物结构、蛋白质结构、生物功能背景和外部知识的互补关系,这也是多模态融合逐渐成为复杂DTI场景重要技术方向的原因。近年来,多模态信息整合与跨层级表示学习已成为DTI预测的重要发展方向。
2.2多模态方法
在DTI预测研究中,“模态”特指具有独立信息来源、明确物理意义及独立表征空间的信息类型,领域内核心模态可分为以下四类:
一是药物配体模态,涵盖药物分子化学序列、分子图谱、分子图像及预训练嵌入等全维度属性信息;
二是靶点蛋白质模态,包括氨基酸序列、接触图谱、空间结构及预训练嵌入等表征靶点属性的信息;
三是生物功能与互作背景模态,包含基因表达谱、化学扰动表型、知识图谱、配体-蛋白接触图等生物学先验知识与互作关联信息;
四是通用语义嵌入模态,特指预训练大语言模型、蛋白质语言模型输出的跨分子类型通用语义表征。
相较于单模态方法,多模态方法的目标并非简单叠加输入,而是通过跨模态对齐形成信息互补。因此,其评价除预测指标外,还应关注模态是否真正互补、计算代价是否过高,以及新增模态是否提升了对特定靶点家族或复杂场景的适应能力。
根据融合模态数量、组合逻辑与技术路径,现有DTI多模态融合方法可分为双模态与多模态(三模态及以上)两类范式。与单模态方法相比,多模态方法整合结构、序列、功能和知识背景信息,可缓解单一表征空间的信息不足,但其模型更复杂,模态对齐更困难,更依赖样本规模、数据清洗和训练资源。因此,多模态模型的收益并不必然遵循“模态越多越好”的规律,而取决于新增模态是否真正互补、模态间能否稳定对齐,以及训练集是否足以支撑复杂的参数化建模。
围绕数据可信度、表征层次、交互建模、跨分布泛化、机制解释与工具化闭环六个环节,可对DTI方法进行系统性比较。沿此框架来看,不同方法家族的差异不仅体现在模型名称上,更体现在其所试图解决的瓶颈及伴随的代价与边界上:传统机器学习侧重小样本条件下的可计算性,但受限于人工特征与相似性假设;深度学习强化了端到端表示与复杂交互建模的能力,却也进一步暴露了冷启动泛化与机制解释方面的不足;多模态与预训练路线弥补了信息来源单一的缺陷,同时引入了更高的对齐难度、训练成本与噪声传播风险。据此,本文不再局限于简单的方法分类,而是在统一框架下讨论技术重心如何从“能否预测”转向“为何有效、对谁有效、以何种代价有效,以及能否嵌入药物发现流程”。
具体而言,多模态方法的代价主要体现在以下三个方面:
1计算资源方面,多模态模型需并行处理多种高维异构输入,各模态编码器各自拥有独立的参数空间与计算管线。以典型双模态模型为例,药物GNN编码器通常包含3~5层图卷积层与若干注意力头,靶点序列编码器也需多层Transformer结构,导致训练阶段的显存占用与计算时间通常为同架构单模态模型的2至5倍[6]。进一步引入知识图谱或基因表达谱等第三模态时,模型参数量可能突破大规模,对GPU集群或超算平台的依赖显著增加[51]。推理阶段,多模态模型因复杂的前向传播路径而面临更高延迟,难以满足高通量虚拟筛选的实时性需求。
2对齐难度方面,不同模态的特征空间在维度、尺度和语义分布上差异显著。药物分子图以原子-键为节点-边关系,靶点蛋白质序列以氨基酸字符序列呈现,知识图谱则表现为稀疏的实体-关系三元组,这种异质性使得直接拼接或简单注意力融合难以实现有效的语义对齐。跨模态对齐需借助额外的投影层、对比学习或注意力融合机制,设计不当易导致信息冗余或关键信号稀释[52]。例如,若药物-靶点交互线索主要存在于结合位点附近的局部结构,而模型在全局层面进行对齐,则可能丢失关键的局部几何信息;反之,若过度依赖局部对齐,又可能忽略全局生物学功能约束。
3过拟合风险方面,多模态融合显著增加了模型参数量与假设空间,在标注数据有限的小样本场景下容易过拟合,削弱模型的泛化能力。特别是当某些模态的样本量不平衡时,模型可能过度拟合样本量较大的主导模态,而忽略稀有模态中蕴含的独特信号[7]。这种过拟合在跨数据集泛化时更为明显,因为外部数据集的模态分布可能与训练集存在系统性偏差,导致模型在冷启动场景下性能大幅下降。
因此,在资源受限场景下,建议根据任务复杂度、数据规模和可用算力进行权衡:若数据规模充足且计算资源充裕,多模态融合通常能带来稳定的性能增益;若标注数据有限或计算预算受限,可优先选择单模态方法配合预训练表示,或采用轻量级的双模态融合策略,以平衡性能与成本。此外,还可通过模态重要性评估、渐进式融合策略和正则化约束等手段,降低对齐难度与过拟合风险,使多模态方法在更广泛的实际场景中发挥作用。
2.2.1 双模态融合范式
双模态融合是DTI模型的基础架构,也是当前领域内应用较广泛的融合范式,核心是围绕DTI二元互作的本质属性,实现两类独立模态的特征对齐与信息互补,整体可分为两个子类。图3概括了多模态DTI预测中不同信息源的组织方式及其融合位置,有助于理解后文双模态、三模态及以上方法之间的结构差异,以及多模态方法为何能在部分复杂场景下获得额外增益。
图3基于多模态的DTI预测方法
2.2.1.1 跨主体双模态融合范式
该范式是DTI领域较常见的双模态基础架构,即分别编码药物端与靶点端信息,再通过拼接或注意力机制完成跨主体融合并输出预测结果。根据技术实现路径的差异,该范式在现有研究中衍生出多条主流技术路线,其中典型的实现路径包括:
1双塔架构融合路径,该路径采用双分支独立编码的结构设计,仅在较终预测层完成特征融合,训练效率高且泛化能力强,尤其适配冷启动场景。该路径下的方法包括MGSDTA[53]、DrugKANs[54]、DeepDTAGen[55]等。
其中,MGSDTA[53]将分子图谱特征与预训练序列嵌入特征整合至统一的多模态框架中,通过专属的加权融合模块实现两类特征的互补适配,有效解决DTI预测中的冷启动难题;
DrugKANs[54]基于双塔架构搭建,分别为药物与靶点设置独立的特征提取分支,结合柯尔莫哥洛夫-阿诺德网络技术完成双分支特征的交互与融合,在提升预测精度的同时有效缓解模型过拟合问题;
DeepDTAGen[55]以药物分子结构特征与靶点蛋白特征为核心输入,构建多任务深度学习框架,可同步完成药物-靶点结合亲和力预测与靶向药物变体生成;在药物选择性测试、定量构效关系分析及冷启动测试中稳健性均较好。
2注意力机制跨模态对齐路径,该路径通过自注意力、交叉注意力机制,在特征编码阶段即可实现药物与靶点两类模态的双向信息交互,能够精准捕捉二者结合过程中的关键互作特征,同时大幅提升模型的可解释性。该路径下的相关方法包括HMSA-DTI[52]、ColdDTA[56]、SSCPA-DTI[57]、DrugLAMP[58]等。
其中,HMSA-DTI[52]以多源药物表征与蛋白质表征为输入,通过分层多模态自注意力机制完成两类特征的深度融合,可逐层挖掘药物与靶点的核心互作信息;
ColdDTA[56]专为冷分割场景设计,通过子图移除的数据增强策略扩充训练样本,同时基于注意力机制搭建特征融合模块,实现药物与蛋白质特征的深度对齐,模型摒弃了传统随机分割的验证方式,全程在冷分割场景下完成训练与性能评估;
SSCPA-DTI[57]是一种高可解释性的DTI预测方法,该方法通过多特征信息挖掘模块,独立提取药物与蛋白质序列的原始特征和亚结构特征,进而基于跨公共注意力机制对上述特征进行交互式融合,高效且精准地挖掘DTI的核心关联信息;
DrugLAMP[58]结合蛋白质语言模型与传统特征提取方法,搭建了口袋引导协同注意力、配对多模态注意力两类专属融合模块,实现预训练序列特征与传统结构理化特征的精准对齐,在冷分割场景中的表现优于同期主流方法,同时可通过注意力图可视化实现模型决策的可解释性。
3自监督预训练融合路径,基于大规模无标注数据学习通用表征,可缓解标注数据稀缺问题,代表性方法如DTIAM[51]可通过自监督预训练联合药物图谱与蛋白质序列特征。
2.2.1.2 同主体内双模态融合范式
该范式是跨主体融合的前置增强模块,核心是针对药物、靶点或分子图这类单一主体,融合其来自不同维度、不同粒度或不同表征空间的两类独立模态,通过对单一主体的精细化表征增强,提升后续跨主体融合的整体效果,根据融合的特征类型可分为两类:
1同主体不同粒度的特征融合,例如AMMVF-DTI[59],其分别提取分子图节点层级的局部嵌入特征与图层级的全局嵌入特征,完成两类不同粒度特征的融合,可同时捕捉药物或靶点分子的局部原子互作信息与全局结构信息;
2同主体不同表征空间的特征融合,例如MMDG-DTI[60],其融合由预训练大语言模型提取的通用文本特征,以及基于GNN得到的DTI任务相关结构特征,通过剔除训练数据中与任务无关的冗余领域信息,减轻了其对模型泛化能力的干扰,从而有效提升了模型在未知样本和跨域场景下的DTI预测性能。
2.2.2 多模态融合范式
多模态融合范式通过引入额外的独立信息维度,突破了双模态融合的信息瓶颈,可同时覆盖分子结构、序列语义、生物功能、互作机制等多维度信息,是当前DTI领域的前沿研究方向。
2.2.2.1 药物多维度模态-靶点模态-功能背景模态三维融合范式
该范式是当前较主流的三模态融合架构,核心是基于药物与靶点基础双模态,引入生物学功能先验信息作为独立的第三模态,实现结构信息、语义信息与功能信息的互补适配,大幅提升模型的生物学合理性与泛化性能。
例如,TriCvT-DTI[61]整合了药物分子图像、药物化学序列、药物图谱表示三类独立的模态表征,可全面捕捉药物分子的结构、空间与功能维度特征,为DTI预测提供全维度的药物信息支撑;
GramSeqDTA[62]通过文法变分自编码器提取药物序列的文法特征,学习药物序列的语义与句法规则,同时融合L1000项目中10 μM标准剂量下978个地标基因的上调/下调化学扰动对应的基因表达信息获取功能特征,结合靶点蛋白核心特征完成三类模态的融合,补充了纯结构特征无法覆盖的体内生物活性信息;
Top-DTI[47]可解决DTI预测中拓扑组件缺失与冷分割场景性能瓶颈,Top-DTI框架整合拓扑数据科学与预训练大语言模型优势:通过持续同调技术,从蛋白质接触图谱(经Transformer模型生成)与药物2D分子图像(基于SMILES via RDKit生成)中,提取连通分量、环结构等拓扑特征,量化为1200维向量;
借助ProtT5(蛋白质序列)与MoLFormer(药物SMILES)预训练模型,生成高维语义嵌入并投影至512维统一空间;通过动态权重融合模块(α自适应分配权重)完成三类模态融合,结合两层SAGEConv-GNN优化特征,在冷分割场景中突破数据分布偏移限制,在BioSNAP unseen数据集与Human Cold数据集上表现优异。
2.2.2.2 跨主体多粒度多维度融合范式
跨主体多粒度多维度融合范式的核心是将药物与靶点两个核心主体,分别拆解为多个不同粒度的独立子模态,再完成跨主体的全维度特征融合,参与融合的模态总数不低于3个,可实现从原子级微观互作到宏观空间结构的全尺度信息覆盖。例如MultiGranDTI[63],其搭建可解释多粒度表征框架,通过带约束分层网络融合四类模态:药物原子级/亚结构特征、蛋白质1~2阶序列特征与空间结构特征(基于Pconsc4接触图)。其同步建模药物多粒度结构与蛋白质多维度信息,适配不同尺度分子结合模式,在4组基准数据集的两类任务中提升预测精度,且通过可视化实现关键功能基团与亚结构识别,保持良好可解释性。
综上,多模态方法可在激酶等数据较丰富任务中稳定提分,并在GPCR、离子通道等稀疏家族中缓解单一模态信息不足,但代价是更高的计算开销与对齐复杂度。从方法演进看,领域重心已由“特征可计算”转向“交互可学习”,再转向“跨分布可泛化”,因此,多模态评价不宜仅关注平均分,还应关注新增模态是否真正提供互补信息,以及其在冷启动、数据漂移和跨家族场景中的稳健性。
3小结与展望
过去二十余年,DTI及DTA预测研究实现跨越式发展,从早期相似性原理、传统机器学习,演进至深度学习、多模态融合及大型预训练模型,成为AI赋能新药研发的核心方向之一。本文系统梳理了DTI预测的核心数据支撑体系,包括药物与靶点多维度表征数据、药物-靶点关联标签数据及Davis、KIBA、BindingDB等通用基准数据集的应用边界。同时阐述了技术演进路径,从单模态传统机器学习、深度学习,到双模态融合、多模态信息整合,明确多模态融合与预训练技术是当前突破性能瓶颈的核心。
在此基础上,本文从数据可信度、表征层次、交互建模、跨分布泛化、机制解释和工具化闭环六个维度重构了方法比较框架。现有DTI方法的主要短板在于:传统方法依赖人工特征与相似性假设,深度学习在冷启动和跨数据库场景中仍易退化,多模态方法则面临模态质量不均、对齐困难和训练成本上升。其根源主要在于数据稀疏、分布偏差和机制监督不足。相应缓解策略包括跨库去冗余、统一标签映射、时间与家族切分评估、难负样本构造、迁移学习或参数高效微调,以及结合位点监督与外部分子模拟校验。
未来DTI预测的发展重点不宜仅概括为“更大模型”或“更多模态”,而应围绕更规范的数据治理、更稳健的跨分布建模和更可验证的机制解释。在数据层面,应推进跨库去冗余、统一标签映射、时间切分与冷启动评测;在模型层面,可采用“预训练表示+结构约束+跨模态对齐”的分层框架;在验证层面,应将模型输出进一步纳入分子对接、分子动力学和体外实验优先级排序。从工具演进来看,DT-Web、TargetNet、BalestraWeb和DINIES等已有工具表明,该领域正从“模型论文”走向“可用工具”。
DTI智能体有望整合文献检索、数据库调用、候选生成、相互作用预测与实验建议,但其实际价值仍取决于数据质量、推理可追溯性及实验闭环的耦合程度。例如,DTI智能体可用于肿瘤精准用药中的候选药物-靶点排序、老药新用中的潜在适应证挖掘,以及临床前阶段的脱靶风险预警,从而为实验优先级决策提供参考。
需要指出的是,DTI预测结果仍需经由靶点生物学评估、体外结合与功能实验,以及细胞和动物水平的药效/安全性研究逐步验证。常见路径为:先完成候选药物-靶点排序,再结合分子对接或分子动力学提出结合位点假设,随后开展表面等离子共振/等温滴定量热、酶活性或细胞表型等实验验证。因此,除报告预测性能外,相关研究还应关注候选靶点的疾病相关证据、作用通路解释及与实验验证的衔接性,以增强其在药理研究和临床前开发中的实际价值。总体而言,未来更值得关注的不是单一模型在标准数据集上指标的再提升,而是如何将DTI预测嵌入“靶点发现-机制假设-药理验证-适应证筛选”的连续流程中,形成对实验决策有实质性助益的证据整合框架。
[1]曾克武, 屠鹏飞. 中药作用靶点方法学研究进展[J]. 中国科学: 化学, 2018, 48(11): 1420-1428.
[2]李冠乔, 孔繁圃. 我国创新药研发活力澎湃[N]. 中国医药报, 2025-02-06(01).
[3]新康界. 重磅系列报告 | 中国创新药, 迈向高质量发展(三)[EB/OL]. (2025-05-16)[2026-03-28]. hg affinity prediction with multiple attention blocks[J]. Brief Bioinform, 2021, 22(5): bbab117.
[5]Qi X, Zhao Y C, Qi Z, et al. Machine learning empowering drug discovery: applications, opportunities and challenges[J]. Molecules, 2024, 29(4): 903.
[6]Sun Y, Li Y Y, Leung C K, et al. iNGNN-DTI: prediction of drug-target interaction with interpretable nested graph neural network and pretrained molecule models[J]. Bioinformatics, 2024, 40(3): btae135.
[7]Zeng X, Li S J, Lv S Q, et al. A comprehensive review of the recent advances on predicting drug-target affinity based on deep learning[J]. Front Pharmacol, 2024, 15: 1375522.
[8]DrugBank. DrugBank online[EB/OL]. [2026-03-28]. https://www.drugbank.com/.
[9]BindingDB. BindingDB[EB/OL]. [2026-03-28]. https://www.bindingdb.org/.
[10]EMBL-EBI. ChEMBL database[EB/OL]. [2026-03-28]. https://www.ebi.ac.uk/chembl.
[11]National Center for Biotechnology Information. PubChem[EB/OL]. [2026-03-28]. https://pubchem.ncbi.nlm .nih.gov/.
[12]UniProt Consortium. UniProt[EB/OL]. [2026-03-28]. https://www.uniprot.org/.
[13]RCSB Protein Data Bank. RCSB PDB[EB/OL]. [2026-03-28]. https://www.rcsb.org/.
[14]Hasselgren C, Oprea T I. Artificial intelligence for drug discovery: are we there yet?[J]. Annu Rev Pharmacol Toxicol, 2024, 64: 527-550.
[15]Naghib Zadeh S, Ecevit Sati Z, Ghanbari Sorkhi A. Improving drug-target interaction prediction using SVM-SMOTE: a solution for imbalanced dataset[J]. Int J Manag Inf Syst Comput Sci, 2025, 9(1): 10-28.
[16]Sathan D, Baichoo S. Drug target interaction prediction using variational quantum classifier[C]//2024 International Conference on Next Generation Computing Applications (NextComp). Piscataway, NJ: IEEE, 2024: 1-7.
[17]Chen F, Zhao Z G, Ren Z, et al. Prediction of drug target interaction based on under sampling strategy and random forest algorithm[J]. PLoS One, 2025, 20(3): e0318420.
[18]Feng Y F, Zhang Y Y, Deng Z Q, et al. GCARDTI: drug-target interaction prediction based on a hybrid mechanism in drug SELFIES[J]. Quant Biol, 2024, 12(2): 141-154.
[19]Li Y, Zhan R H, Rao J X, et al. Structure-informed machine learning for drug discovery: a task-centric perspective[J]. Brief Bioinform, 2026, 27(1): bbag081.
[20]Bagherian M, Sabeti E, Wang K, et al. Machine learning approaches and databases for prediction of drug-target interaction: a survey paper[J]. Brief Bioinform, 2021, 22(1): 247-269.
[21]Xu W Y, Yang X X, Guan Y L, et al. Integrative approach for predicting drug-target interactions via matrix factorization and broad learning systems[J]. Math Biosci Eng, 2024, 21(2): 2608-2625.
[22]Zhong N Y, Du Z H. NASNet-DTI: accurate drug-target interaction prediction using heterogeneous graphs and node adaptation[J]. Brief Bioinform, 2025, 26(4): bbaf342.
[23]Zhou M S, Zheng C L, Xu R. Combining phenome-driven drug-target interaction prediction with patients' electronic health records-based clinical corroboration toward drug discovery[J]. Bioinformatics, 2020, 36(S1): i436-i444.
[24]Yu D H, Liu G J, Zhao N, et al. FPSC-DTI: drug-target interaction prediction based on feature projection fuzzy classification and super cluster fusion[J]. Mol Omics, 2020, 16(6): 583-591.
[25]Jamali A A, Kusalik A, Wu F X. NMTF-DTI: a nonnega-tive matrix tri-factorization approach with multiple kernel fusion for drug-target interaction prediction[J]. IEEE/ACM Trans Comput Biol Bioinform, 2023, 20(1): 586-594.
[26]Ling C J, Zeng T, Dang Q, et al. Predicting drug-target interactions using matrix factorization with self-paced learning and dual similarity information[J]. Technol Health Care, 2024, 32(S1): 49-64.
[27]Liu B, Tsoumakas G. Integrating similarities via local Interaction consistency and optimizing area under the curve measures via matrix factorization for drug-target Interaction prediction[J]. IEEE/ACM Trans Comput Biol Bioinform, 2024, 21(6): 2212-2225.
[28]Song W, Xu L W, Han C G, et al. Drug-target interaction predictions with multi-view similarity network fusion strategy and deep interactive attention mechanism[J]. Bioinformatics, 2024, 40(6): btae346.
[29]Su Y S, Hu Z Y, Wang F, et al. AMGDTI: drug-target interaction prediction based on adaptive meta-graph learning in heterogeneous network[J]. Brief Bioinform, 2023, 25(1): bbad474.
[30]Lu Y J X, Kang S, Kim S, et al. EnsDTI: predicting drug-target interaction with mixture-of-experts and confidence assessment[J]. IEEE Trans Comput Biol Bioinform, 2026, 23(3): 974-984.
[31]Zhang Y, Liao Q, Tiwari P, et al. MvG-NRLMF: multi-view graph neighborhood regularized logistic matrix factorization for identifying drug-target interaction[J]. Future Gener Comput Syst, 2024, 160: 844-853.
[32]Monteiro N R C, Ribeiro B, Arrais J P. Drug-target interaction prediction: end-to-end deep learning approach[J]. IEEE/ACM Trans Comput Biol Bioinform, 2021, 18(6): 2364-2374.
[33]Zhao Y H, Zheng K, Guan B Y, et al. DLDTI: a learning-based framework for drug-target interaction identification using neural networks and network representation[J]. J Transl Med, 2020, 18(1): 434.
[34]Peng J J, Wang Y X, Guan J J, et al. An end-to-end heterogeneous graph representation learning-based framework for drug-target interaction prediction[J]. Brief Bioinform, 2021, 22(5): bbaa430.
[35]Li M, Cai X, Li L, et al. Heterogeneous graph attention network for drug-target interaction prediction[C]//Proceedings of the 31st ACM International Conference on Information & Knowledge Management. New York: Association for Computing Machinery, 2022: 1166-1176.
[36]Yin Q J, Fan R, Cao X S, et al. DeepDrug: a general graph-based deep learning framework for drug-drug interactions and drug-target interactions prediction[J]. Quant Biol, 2023, 11(3): 260-274.
[37]Yu Q Z, Zhou C, Jiang J Y, et al. GS-DTI: a graph-structure-aware framework leveraging large language models for drug-target interaction prediction[J]. Bioinformatics, 2025, 41(8): btaf445.
[38]Cheng Z J, Yan C, Wu F X, et al. Drug-target interaction prediction using multi-head self-attention and graph attention network[J]. IEEE/ACM Trans Comput Biol Bioinform, 2022, 19(4): 2208-2218.
[39]Wang T J, Liu X. A graph convolution-transformer neural network for drug-target interaction prediction[C]//Proceedings of the 14th International Conference on Bioinformatics and Biomedical Technology. New York: Association for Computing Machinery, 2022: 145-150.
[40]Wen J H, Gan H T, Yang Z, et al. Mutual-DTI: a mutual interaction feature-based neural network for drug-target protein interaction prediction[J]. Math Biosci Eng, 2023, 20(6): 10610-10625.
[41]Huang K X, Xiao C, Glass L M, et al. MolTrans: Molecular Interaction Transformer for drug-target interaction prediction[J]. Bioinformatics, 2021, 37(6): 830-836.
[42]Liu S Y, Wang Y S, Deng Y F, et al. Improved drug-target interaction prediction with intermolecular graph transformer[J]. Brief Bioinform, 2022, 23(5): bbac162.
[43]Jin Y, Lu J R, Shi R H, et al. EmbedDTI: enhancing the molecular representations via sequence embedding and graph convolutional network for the prediction of drug-target interaction[J]. Biomolecules, 2021, 11(12): 1783.
[44]Zheng Y B, Tang P, Qiu W D, et al. A novel deep learning framework for interpretable drug-target interaction prediction with attention and multi-task mechanism[C]//Database Systems for Advanced Applications. Cham: Springer Nature Switzerland, 2023: 336-352.
[45]Ahmed K T, Ansari M I, Zhang W. DTI-LM: language model powered drug-target interaction prediction[J]. Bioinformatics, 2024, 40(9): btae533.
[46]Wu Z H, Zhang X L, Lin X L. KGAT: predicting drug-target interaction based on knowledge graph attention network[C]//Intelligent Computing Theories and Application. Cham: Springer International Publishing, 2022: 438-450.
[47]Talo M, Bozdag S. Top-DTI: integrating topological deep learning and large language models for drug-target interaction prediction[J]. Bioinformatics, 2025, 41(S1): i133-i141.
[48]Hu J, Hu S, Xia M H, et al. Drug-target binding affinity prediction based on power graph and Word2vec[J]. BMC Med Genomics, 2025, 18(1): 9.
[49]Pahikkala T, Airola A, Pietilä S, et al. Toward more realistic drug-target interaction predictions[J]. Brief Bioinform, 2015, 16(2): 325-337.
[50]He T, Heidemeyer M, Ban F Q, et al. SimBoost: a read-across approach for predicting drug-target binding affinities using gradient boosting machines[J]. J Cheminform, 2017, 9(1): 24.
[51]Lu Z L, Song G Q, Zhu H M, et al. DTIAM: a unified framework for predicting drug-target interactions, binding affinities and drug mechanisms[J]. Nat Commun, 2025, 16(1): 2548.
[52]Bian J L, Lu H, Dong G H, et al. Hierarchical multimodal self-attention-based graph neural network for DTI prediction[J]. Brief Bioinform, 2024, 25(4): bbae293.
[53]Tang X, Lei X J, Liu L. A multi-modal drug target affinity prediction based on graph features and pre-trained sequence embeddings[J]. Interdiscip Sci, 2025, 17(4): 822-843.
[54]Fu X Z, Du Z Y, Chen Y F, et al. DrugKANs: a paradigm to enhance drug-target interaction prediction with KANs[J]. IEEE J Biomed Health Inform, 2026, 30(6): 4560-4571.
[55]Shah P M, Zhu H M, Lu Z L, et al. DeepDTAGen: a multitask deep learning framework for drug-target affinity prediction and target-aware drugs generation[J]. Nat Commun, 2025, 16(1): 5021.
[56]Fang K J, Zhang Y M, Du S Y, et al. ColdDTA: utilizing data augmentation and attention-based feature fusion for drug-target binding affinity prediction[J]. Comput Biol Med, 2023, 164: 107372.
[57]Shi H K, Hu J, Zhang X L, et al. Prediction of drug-target interactions based on substructure subsequences and cross-public attention mechanism[J]. PLoS One, 2025, 20(5): e0324146.
[58]Luo Z C, Wu W, Sun Q C, et al. Accurate and transferable drug-target interaction prediction with DrugLAMP[J]. Bioinformatics, 2024, 40(12): btae693.
[59]Wang L, Zhou Y F, Chen Q. AMMVF-DTI: a novel model predicting drug-target interactions based on attention mechanism and multi-view fusion[J]. Int J Mol Sci, 2023, 24(18): 14142.
[60]Hua Y, Feng Z H, Song X N, et al. MMDG-DTI: drug-target interaction prediction via multimodal feature fusion and domain generalization[J]. Pattern Recognit, 2025, 157: 110887.
[61]Maroua A, Tian G, Wang R, et al. TriCvT-DTI: predicting drug-target interactions using trimodal representations and convolutional vision transformers[J]. IEEE J Biomed Health Inform, 2025, 29(6): 4585-4592.
[62]Debnath K, Rana P, Ghosh P. GramSeq-DTA: a grammar-based drug-target affinity prediction approach fusing gene expression information[J]. Biomolecules, 2025, 15(3): 405.
[63]Gong X, Liu Q, He J, et al. MultiGranDTI: an explainable multi-granularity representation framework for drug-target interaction prediction[J]. Appl Intell, 2024, 55(2): 107.
 使用【微信】扫一扫加好友